In-Context Operator Networks: A Research Program for Numerical Intelligence
超越语言的智能
智能通常被理解为获取和应用知识、适应陌生情境以及解决新问题的能力。大语言模型通过从文本上下文中推断与任务相关的知识,并将其应用于新任务,展现了这种能力。然而,智能并不必局限于语言。科学与社会系统往往先通过数值显现出来,然后才被语言完整描述:交通在路网上流动,水流穿过河流流域,物理场随时间和空间演化。这些观测中包含着预测关系;在我们为它们命名、建立形式化描述或训练专用模型之前,这些关系就可能已经可以从数据中学习。
我们将从这样的数值上下文中获取并应用知识的能力称为“数值智能”(numerical intelligence),并把它视为与语言智能并列的人工智能基础支柱。数值智能直接将测量本身作为上下文:模型感知原始数值观测,从中推断组织这些观测的机制或预测关系,并在无需先将观测翻译成语言的情况下,对陌生系统进行推理。
与传统深度学习不同,数值智能并不把某一个具体系统的规律固化在模型权重中,也不依赖为每个新应用重新训练模型。相反,权重编码的是从数值上下文中推理的通用能力,而数值提示提供当前系统所需的知识,使冻结模型能够在推理时完成适应。
这项能力之所以重要,是因为塑造科学、社会与商业的系统——从气候、能源到城市、市场与供应链——都在持续通过测量显现出来。把不断变化的数据及时转化为对系统行为的理解、可靠的预测和行动,让人工智能能够直接连接可测量的现实世界。
算子:一种共同语言
要让数值智能跨越不同系统,首先需要用一种共同的数学语言描述那些表面上彼此无关的问题。算子提供了这样的语言。一个算子是函数空间或场空间之间的映射:
\[\mathcal{F}: \mathcal{X}\to\mathcal{Y}, \qquad y(\cdot)=\mathcal{F}[x(\cdot)].\]不同于把一个数值映射成另一个数值的逐点规律,算子的输入是一个完整的函数或场,输出也是另一个函数或场。同一种抽象可以覆盖许多任务:预测可以把交通密度场向未来演化,物理建模可以把降雨场映射为河流流量,逆问题可以从观测中恢复未知的系数场,控制问题则可以把目标状态映射为行动。对于一个具体问题,算子由系统的控制规律及其参数、任务的表述方式、区域或几何、边界与外部驱动条件,以及输入输出变量的定义共同决定。算子逼近的目标,就是计算或学习这种函数到函数的映射。
举一个具体的例子,考虑一个一维守恒律
\[\partial_t u(t,x) + \partial_x f(u(t,x)) = 0.\]在固定的周期性空间区域上,选定通量函数 \(f\) 和演化时间 \(\tau\) 后,这个守恒律就定义了一个解算子
\[\mathcal{F}_{f,\tau}[u(0,\cdot)] = u(\tau,\cdot),\]也可以更紧凑地写成 \(\mathcal{F}_{f,\tau}(u_0) = u_\tau\)。它的输入是完整的初始剖面 \(u_0(x)\),输出是完整的演化后剖面 \(u(\tau,x)\)。因此,这里的算子并不是 PDE 中出现的某个微分符号,而是由方程诱导出的完整演化规律。由于这里始终固定空间区域和周期性边界条件,这个算子族只随 \(f\) 和 \(\tau\) 改变。
经典数值方法在控制方程已知后计算一个已经指定的算子;固定算子学习则用模型 \(G_\theta\) 逼近它,使得 \(G_\theta(u_0)\approx \mathcal{F}_{f,\tau}(u_0)\)。两种方式都预先固定了算子:一旦算子改变,就需要重新构造求解器,或者重新训练、微调模型。
In-Context Operator Networks(ICON) 把算子的指定方式移到了上下文中。ICON 不再为每个固定算子分别训练模型,而是让一个统一模型 \(T_\theta\) 面对一族算子,并接收少量输入输出样例作为数值提示:
\[\widehat{u}_\tau^{(q)} = T_\theta\!\left(\{(u_0^{(i)},u_\tau^{(i)})\}_{i=1}^{k},\, u_0^{(q)}\right).\]这些样例指出当前查询所需的算子,而模型权重提供推断并应用算子的通用能力;测试时不需要更新权重。这正是上文所说数值智能的一种数学实现:当前系统的知识通过测量进入模型,而不是通过重新训练写入权重。
这种表述也澄清了机器学习处理数值系统的三个阶段。第一阶段逼近单个解函数,例如 Physics-Informed Neural Networks。第二阶段逼近固定的解算子,例如 DeepONet 和 Fourier Neural Operator。ICON 指向第三个阶段:预测关系本身由模型从数值上下文中推断,再由冻结模型加以应用。目标不再只是把某一个算子逼近得足够好,而是让模型能够在上下文中获取和使用新的数值知识。
一条研究线索
我们关于 ICON 的工作,是沿着一系列论文逐步展开的。每篇论文都把这个框架推进了一步。
* 共同第一作者 † 通讯作者
In-Context Operator Learning with Data Prompts for Differential Equation Problems (PNAS 2023)
Liu Yang, Siting Liu, Tingwei Meng, Stanley J. Osher†
这篇论文提出了 in-context operator learning 和 ICON。一个统一模型在不微调的前提下,处理了 19 类正向与逆向的 ODE、PDE 和 mean-field control 问题;这些问题每一类都包含许多具体算子,key functions 与 value functions 则从一维函数延伸到二维时空场。
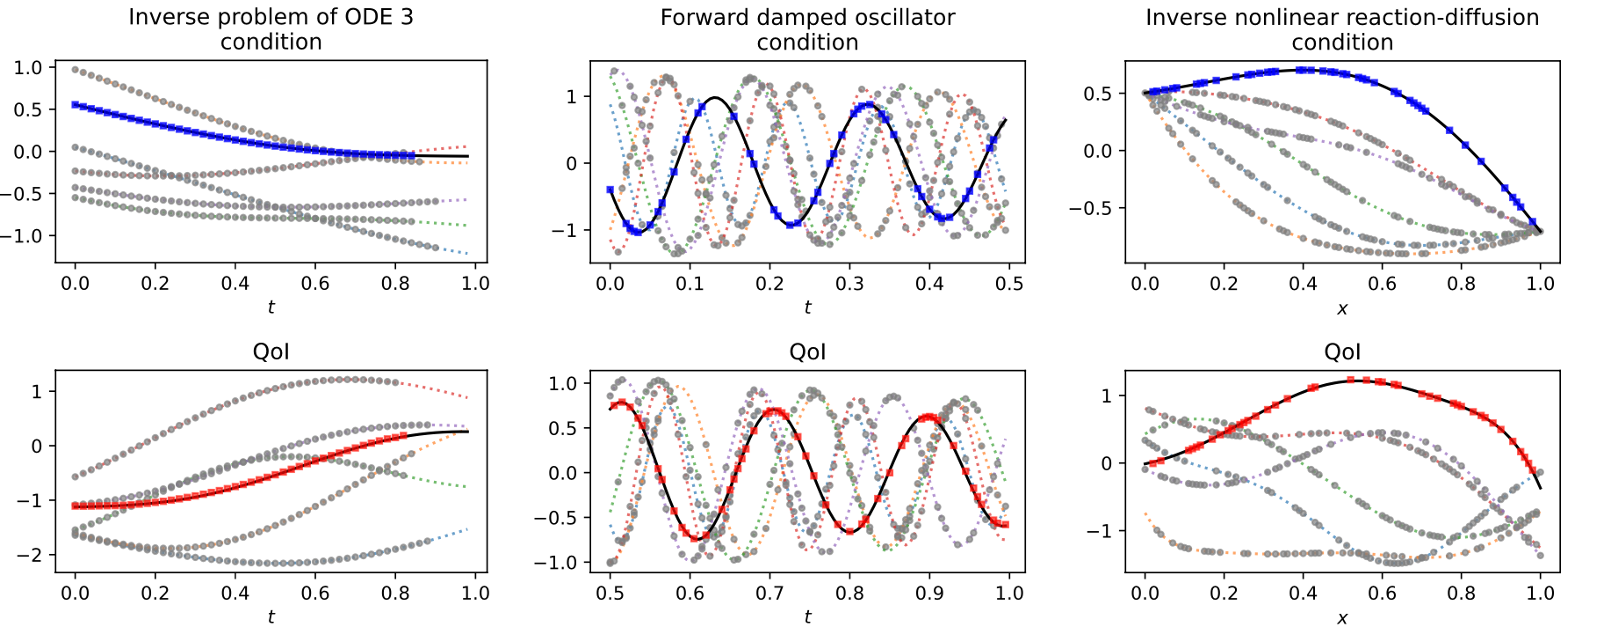
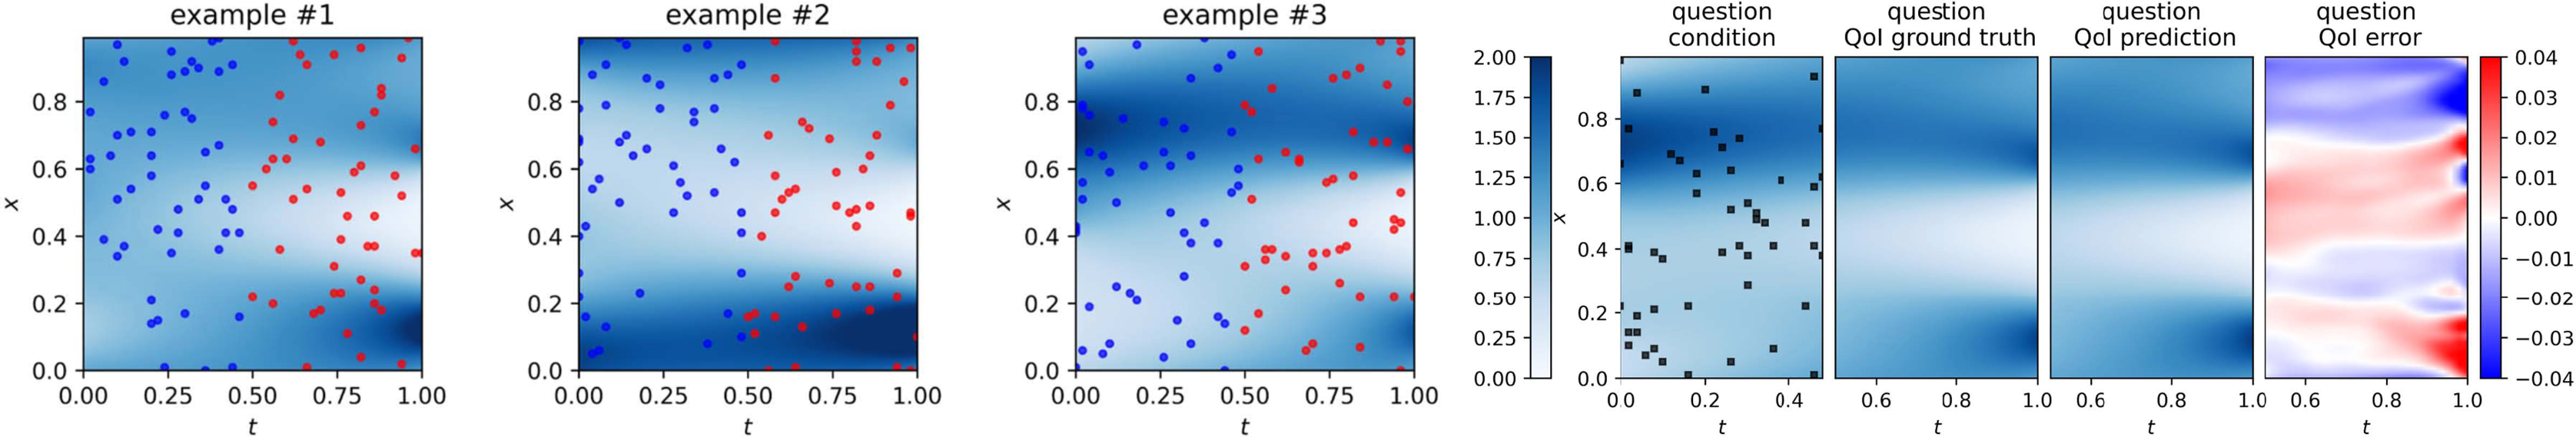
图 1:ICON 横跨 1D 与 2D 问题。第一幅图展示选取的 1D 正向与逆向 ODE、PDE 问题:上排为 key functions,下排为 value functions(原论文称为 conditions 和 QoIs);灰点构成数值上下文样例,蓝点是问题,红点是预测,实线表示 ground truth,并与预测基本重合。第二幅图展示一个 2D-to-2D mean-field control 问题:左侧是三个数值上下文样例,右侧依次是 query key function、ground-truth value function、predicted value function 和 prediction error。模型从这些样例中推断算子,并在一次前向传播中求解二维时空查询。
PDE Generalization of In-Context Operator Networks (JCP 2024)
Liu Yang, Stanley J. Osher†
在这篇工作中,我们验证了一个统一的 ICON 模型能够在不同通量函数、不同时间步长的守恒律之间泛化,甚至泛化到此前未见过的 PDE 形式。我们还研究了 prompt design 策略,例如变量变换和 varying forecast horizon,以拓展模型可处理的问题范围。
Fine-Tune Language Models as Multi-Modal Differential Equation Solvers (Neural Networks 2025)
Liu Yang, Siting Liu, and Stanley J. Osher†
这篇工作采用了 decoder-only、language-model 风格的架构,并引入了 multi-modal prompting。模型不仅可以使用数值样例,还可以同时利用自然语言和 LaTeX 方程,为语言与数值两种上下文之间建立了一个早期接口。
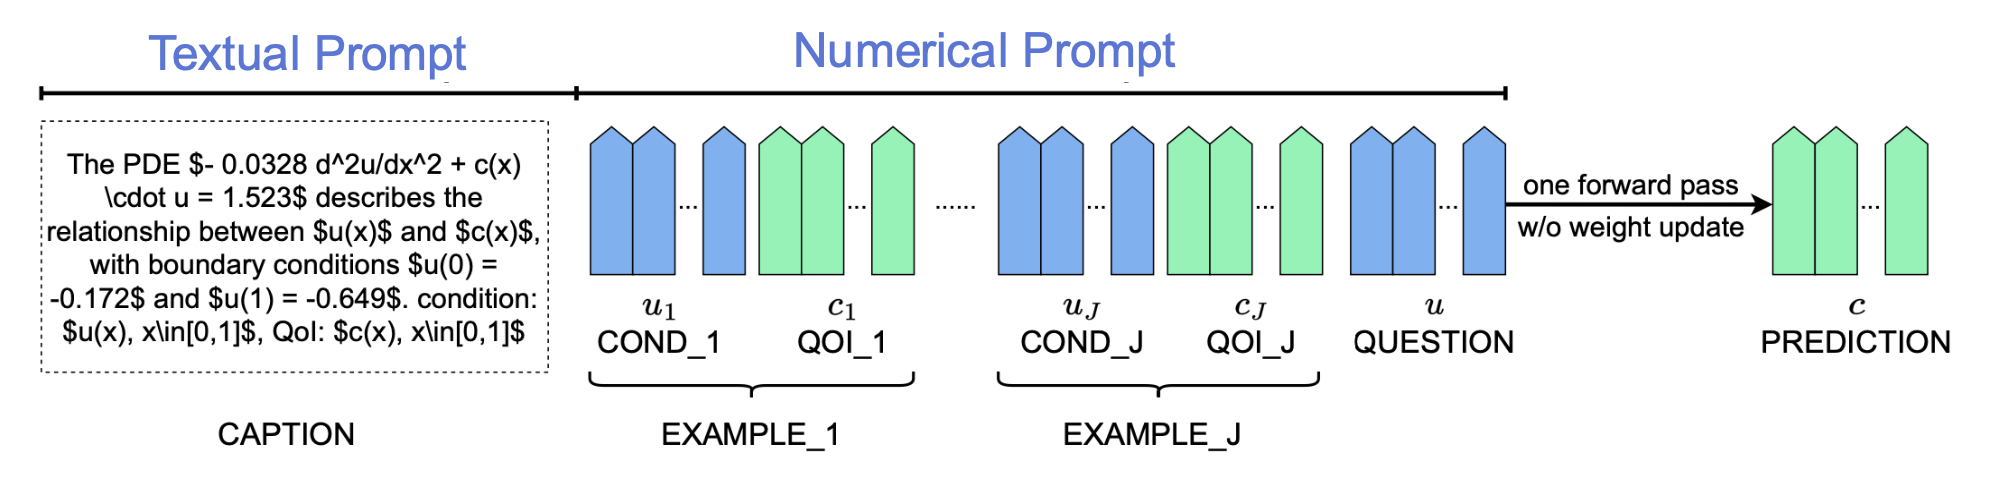
图 2:多模态 in-context operator learning。文本描述和数值样例都可以作为关于当前算子的上下文信息。
VICON: Vision In-Context Operator Networks for Multi-Physics Fluid Dynamics Prediction (TMLR 2026)
Yadi Cao*, Yuxuan Liu*, Liu Yang, Rose Yu, Hayden Schaeffer, Stanley Osher†
VICON 把这个框架扩展到二维场,使用 patch-wise vision transformer,面向多物理流体动力学问题,并支持灵活的 rollout,以及部分缺帧的情形。
GICON: Graph In-Context Operator Networks for Generalizable Spatiotemporal Prediction (2nd ICML Workshop on Foundation Models for Structured Data 2026, arXiv)
Chenghan Wu, Zongmin Yu, Boai Sun, Liu Yang†
GICON 则把同样的思想带到图结构系统中,使用 graph message passing 和 example-aware positional encoding。图为不规则区域上的数值观测提供了统一表示,它进一步在真实时空问题上研究几何泛化和样例数量泛化。
In-Context Modeling as a Retrain-Free Paradigm for Foundation Models in Computational Science (arXiv 2026)
Lingfeng Li*, Zhuoyuan Li*, Shun Li*, Kaixin Zhan, Huajian Gao†, Changqing Chen†, Liu Yang†
In-Context Modeling(ICM)把 in-context learning 与 physics-informed training 连接起来。训练不需要成对的输入输出标签,而是由控制方程提供训练信号;观测场则作为 physical context 输入模型。推理时,冻结模型吸收新的测量,并在一次前向传播中回答新的场查询。这样既保留了 physics-informed learning 无需标签监督的优点,也摆脱了通常需要为每个具体问题重新优化模型的开销:同一个模型无需重新训练,就能泛化到未见过的材料、几何和加载条件。
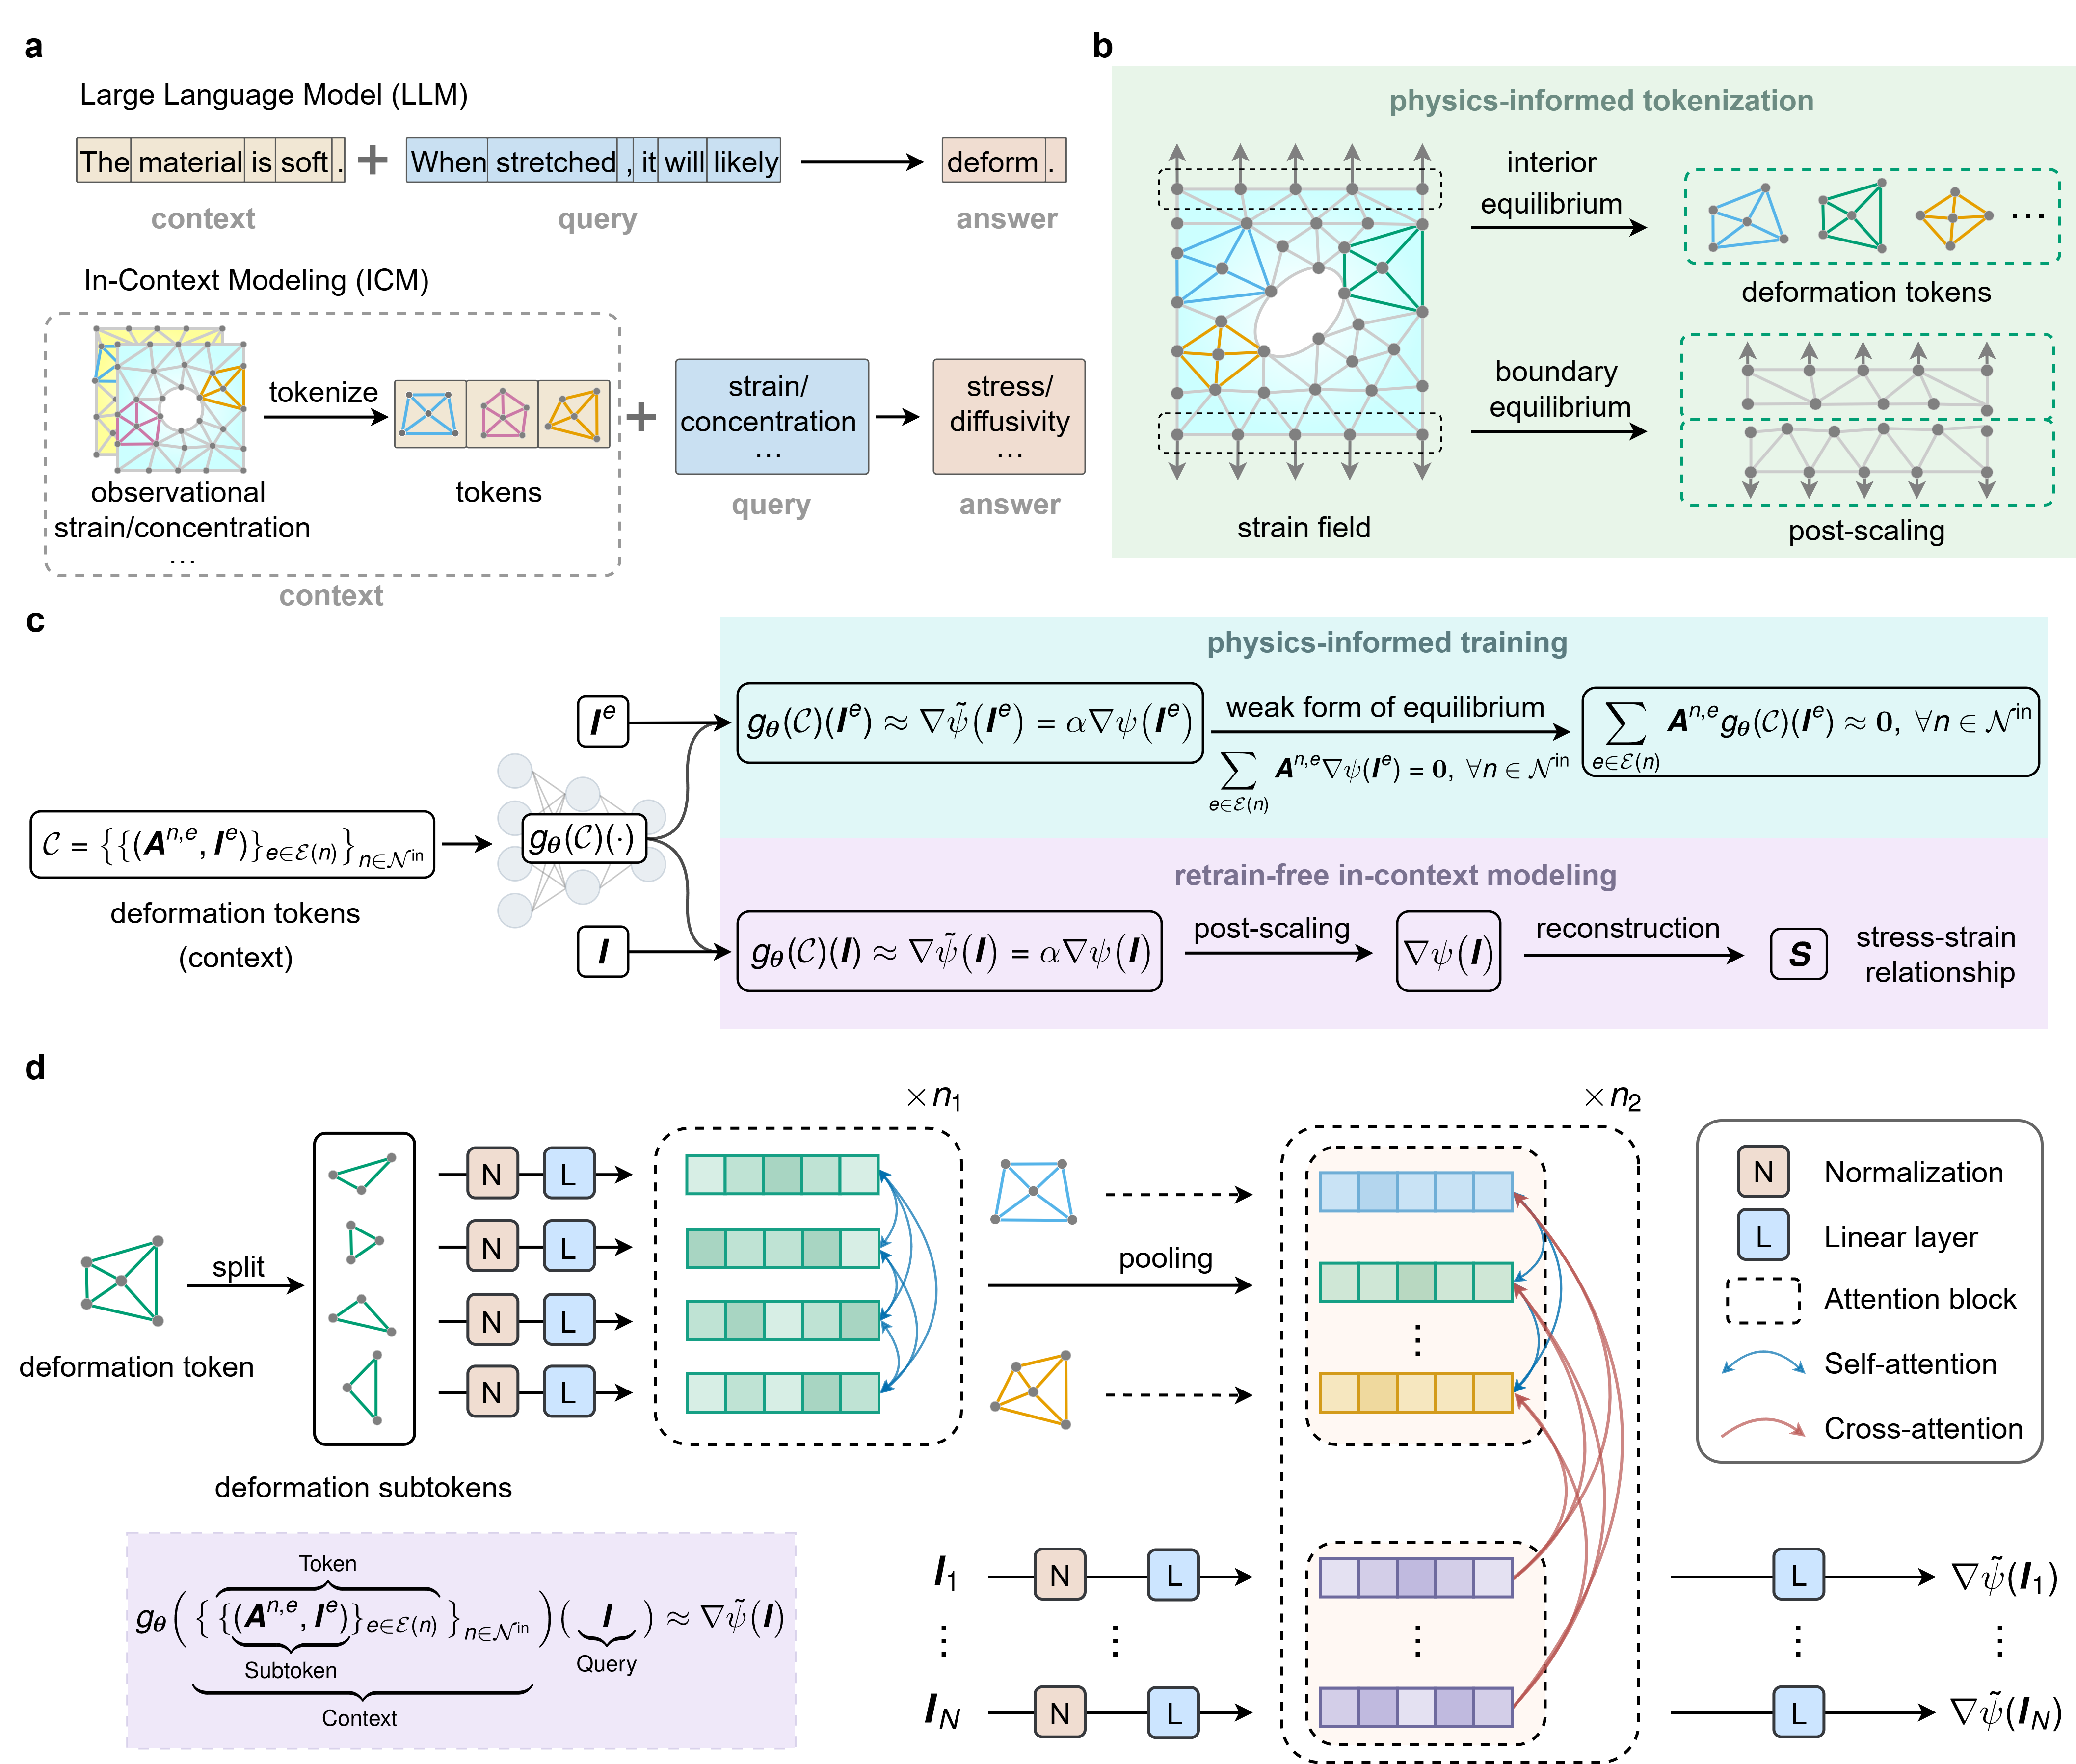
图 3:ICM 总览。观测场被转换为 physics-informed tokens,控制方程提供无标签的训练信号,冻结的 attention-based model 则从上下文中推断未知的物理关系,无需重新训练。
VICX: Generalizable Robot Manipulation via Video Generation and In-Context Operator Network (arXiv 2026, Project)
Song Chen*, Linyan Xiang*, Ying Zhou, Liu Yang†
VICX 把 ICON 这条研究线索进一步延伸到 embodied AI。冻结的视频生成模型负责给出高层视觉规划,而 V2T-ICON 使用检索得到的 image-state examples 作为上下文提示,把生成的视频落地为可执行的机器人状态轨迹。这样,视觉到状态的 grounding 就被转化为一个算子推断问题,也把 in-context operator learning 与闭环机器人操作连接起来。
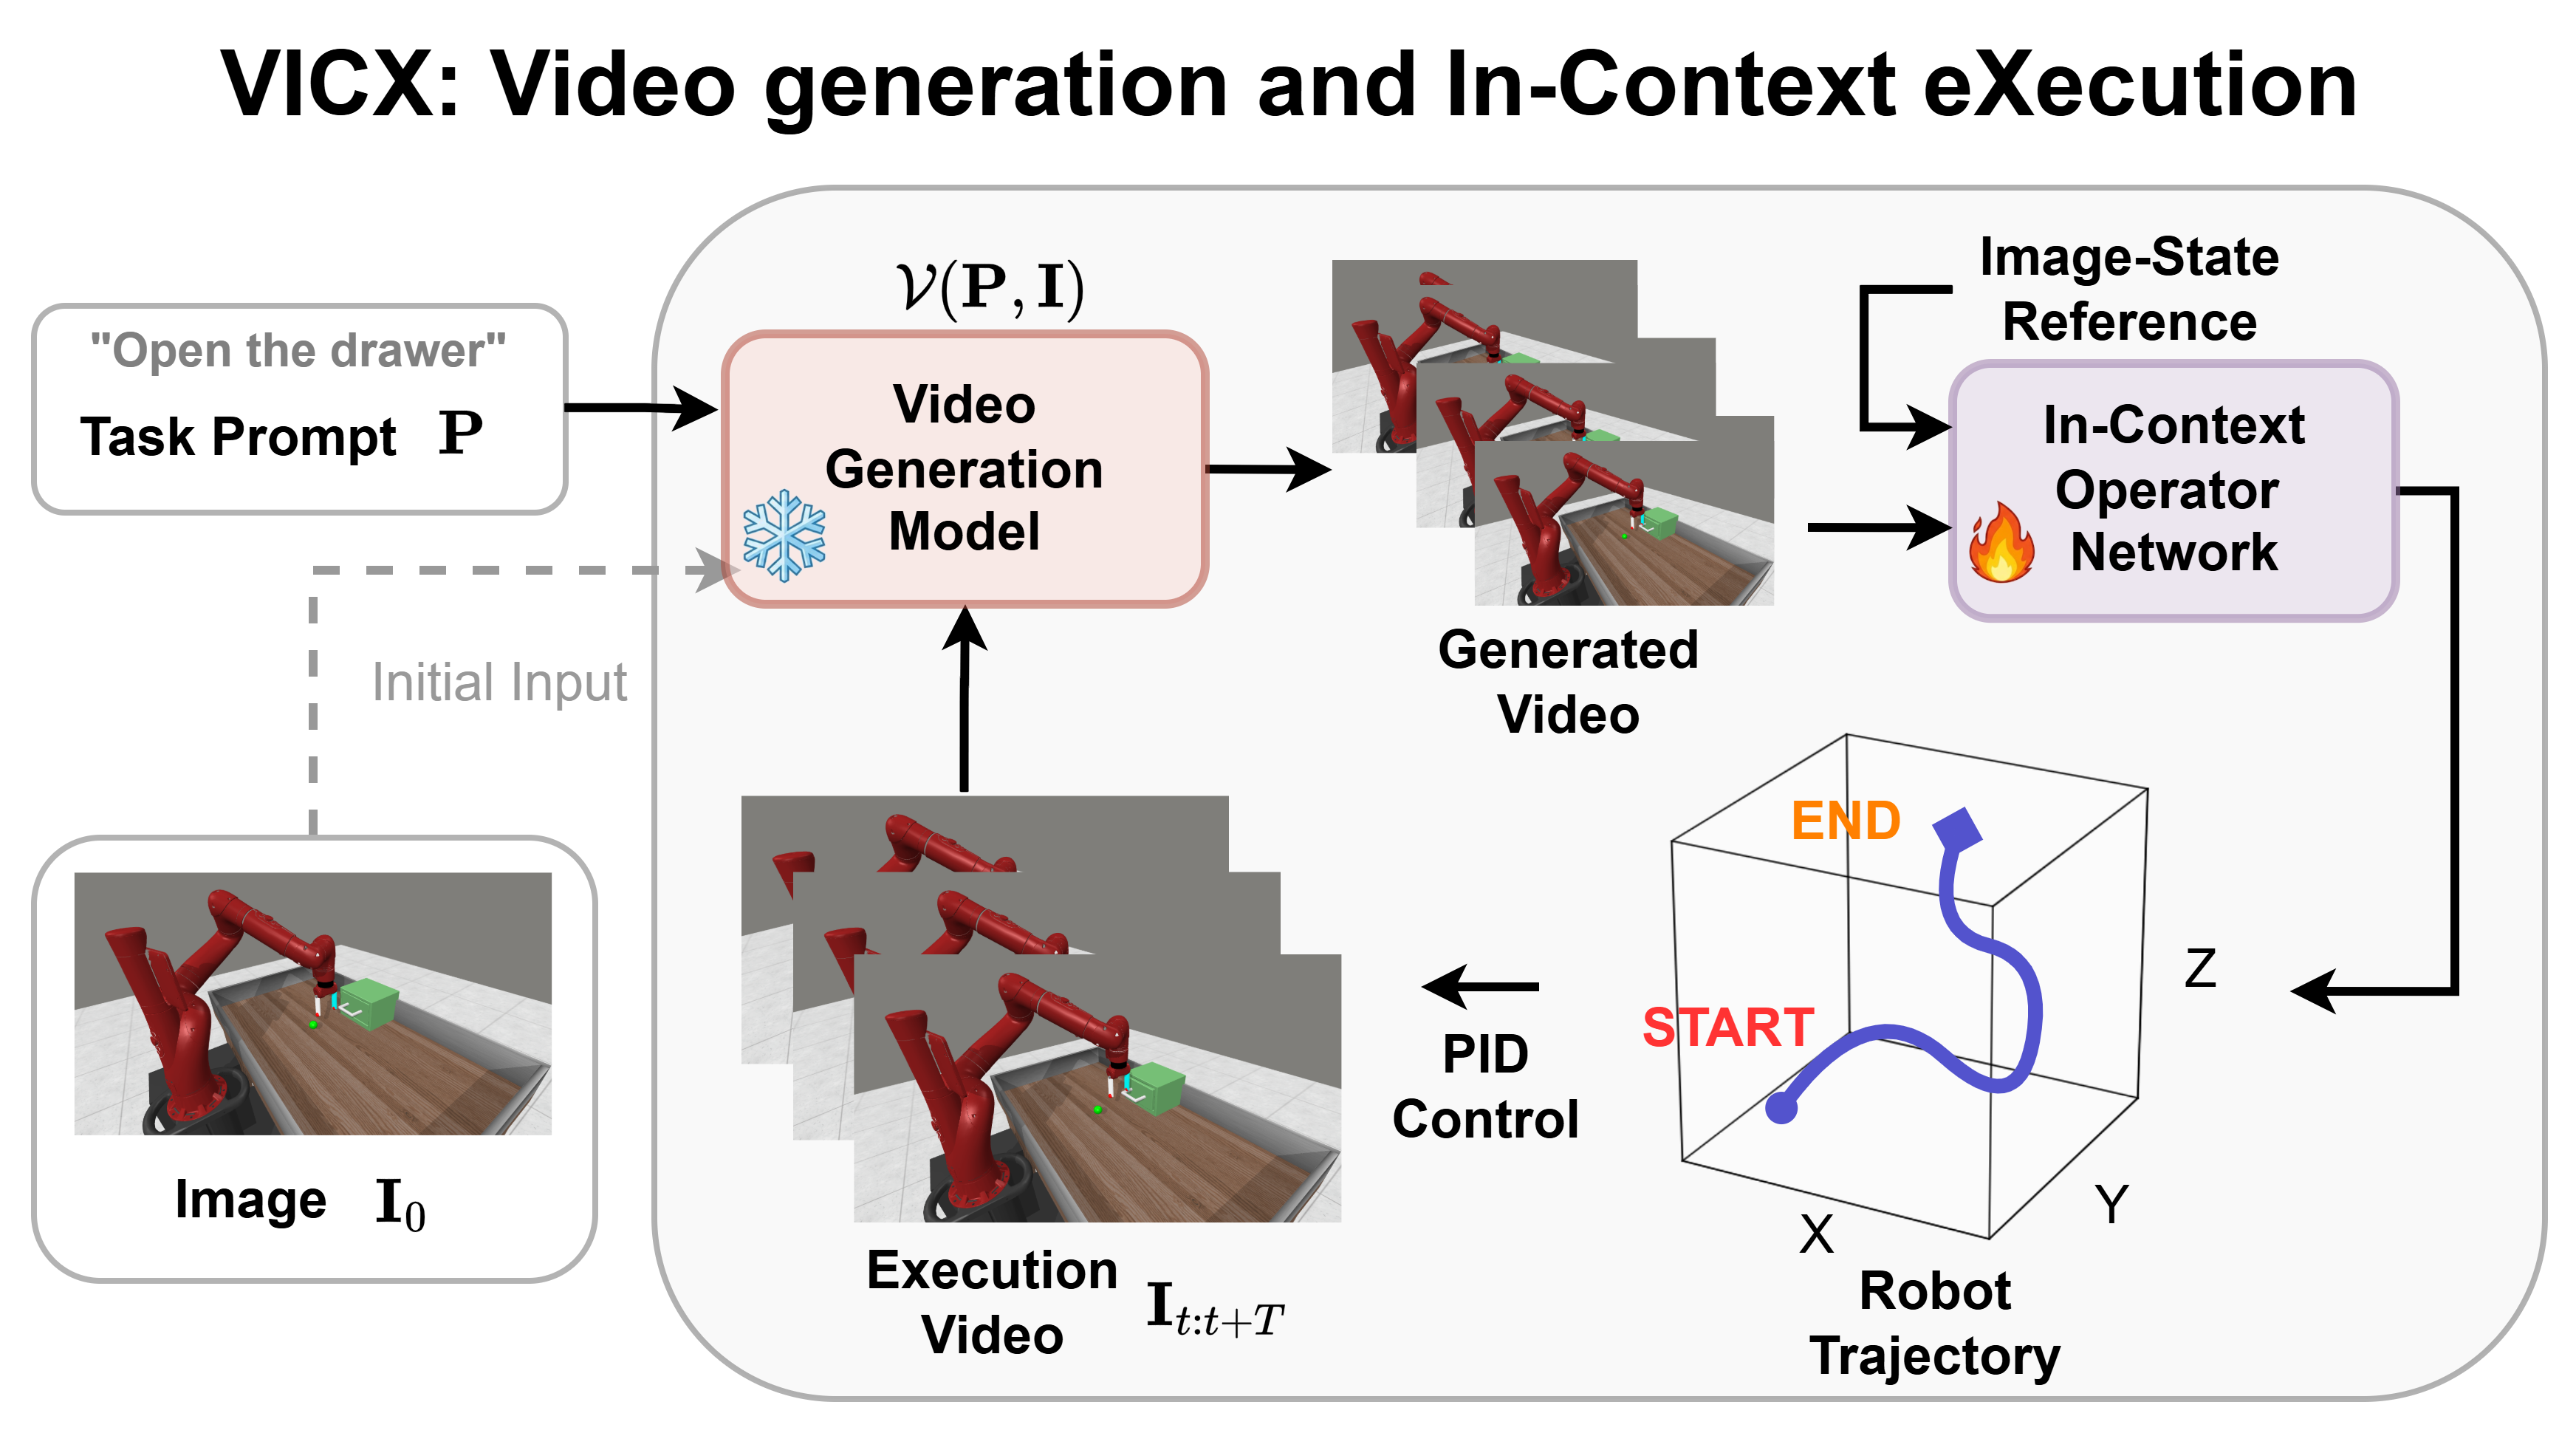
图 4:VICX 框架。冻结的视频生成模型提出视觉规划,V2T-ICON 利用 image-state references 将其落地为机器人轨迹。
A Foundation Model of Numerical Intelligence with Cross-Disciplinary Generalization (arXiv 2026)
Chenghan Wu, Zongmin Yu, Liu Yang†
UNICON 把 ICON 推进到跨学科规模,也让“数值智能”成为一个可以具体检验的命题。一个统一模型先在水文学、交通、电力系统、天气、陆地、海洋、土壤、太阳能和人类移动等数值系统上训练,然后冻结。在推理时,UNICON 从新系统的图结构样例中推断这些样例所表达的预测关系,再将其应用到新的查询上。同一个模型即使面对训练中完全未出现的学科,包括网络活动与空气质量,也能接近专用模型的表现。将 UNICON 与语言模型智能体结合,由智能体执行 contextual ensemble learning(CEL),能够进一步提升表现,使 UNICON 在一个训练中未见的学科上超越最先进的专用模型。实验也表明,更多样化的训练语料能够改善对未见系统和学科的泛化。
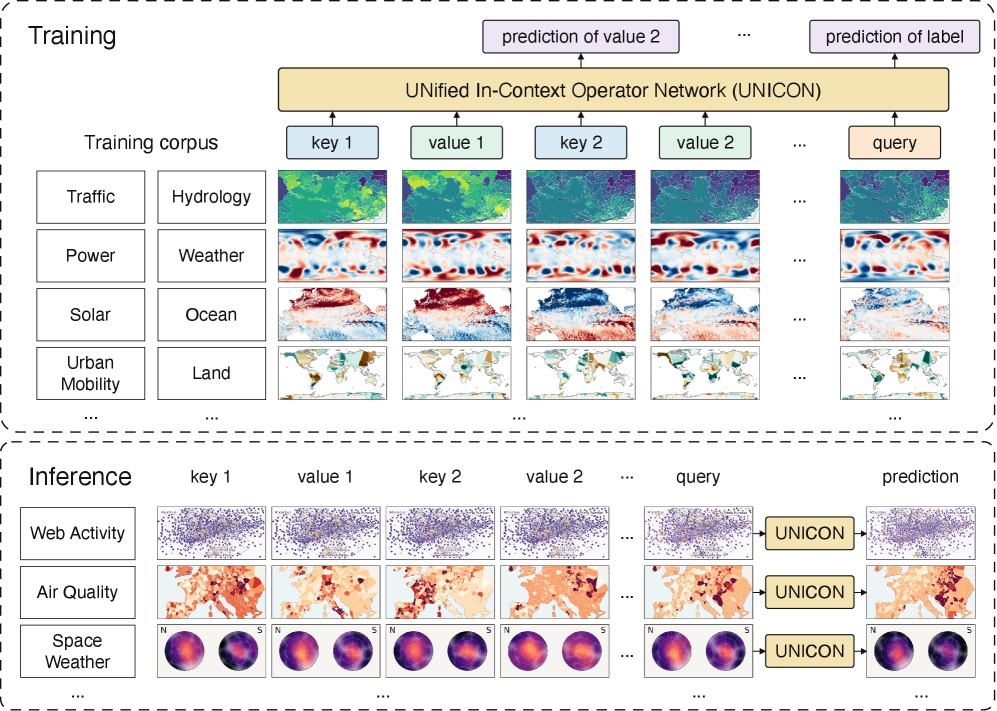
图 5:UNICON 学习如何从图结构数值上下文中学习,再把这种能力应用到训练中未出现的系统和学科。
可编程的 ICON Harness
In-context operator learning 的一个基础洞见是:同一个数值问题,可以通过重构它的提示,以不同方式交给模型求解。数学上等价的表达并不一定让冻结模型产生完全相同的行为;某一种表达可能把问题带入模型更擅长、更可靠的区域。这为不经重新训练而改进推理提供了一条新路径。
我们把利用这种自由度的机制称为推理时 harness:它是包裹在冻结模型之外的可编程层,负责构造和变换数值提示、选择样例、编排模型调用,并处理或融合输出,但不更新模型权重。与语言模型的 harness 类似,它通过代码将一个通用基础模型转化为适应具体任务的系统,还可以量化不确定性,并在推理过程中施加显式的数学规则。在我们的工作中,这个想法逐渐发展为一条持续推进的研究线索:
PDE Generalization of In-Context Operator Networks: A Study on 1D Scalar Nonlinear Conservation Laws (JCP 2024)
Liu Yang, Stanley J. Osher†
变量变换与 varying forecast horizon。 这些策略先重构数值查询,再把它交给 ICON。它们表明,提示空间中的变换能够拓展同一个冻结模型可以处理的问题范围。
Chain of Operators: An Inference-Time Harness for In-Context Operator Learning (arXiv 2026)
Minghui Yang, Chenghan Wu, Ling Guo, Liu Yang†
Chain of Operators(CHOP)。 这篇工作把提示重构发展为一个组合式 harness。CHOP 让数值提示经过一系列显式的初等算子变换,把困难查询转换到冻结 ICON 更有能力处理的中间表示,再将结果映射回来。
A Foundation Model of Numerical Intelligence with Cross-Disciplinary Generalization (arXiv 2026)
Chenghan Wu, Zongmin Yu, Liu Yang†
Contextual Ensemble Learning(CEL)。 CEL 编排多样化的上下文构造路径,并融合各条路径的预测。通过从不同的观测切片构造上下文,CEL 系统地向冻结网络呈现系统的互补侧面,再融合这些局部视角,从而更加可靠地逼近目标算子。
这些方法共享同一个原则:训练得到一个有能力的 in-context learner 之后,进一步的适应可以通过对它的数值提示空间和模型调用序列进行编程来实现。借助 harness,冻结 ICON 的推理行为可以在不更新权重的情况下通过程序编排,从而将获得通用上下文学习能力的高成本训练与面向具体任务的推理编排分离开来。
语言智能与数值智能
语言智能与数值智能处理的是不同形式的上下文。语言智能从文字中获取和应用知识,包括任务描述、元数据、科学概念、约束与领域经验;数值智能则从观测中获取和应用知识,包括图信号、场、多变量序列,以及揭示系统行为的成对样例。
二者的关系不是竞争,而是互补。语言模型智能体可以理解高层目标,并利用语义和领域知识设计推理 harness:选择样例、构造多组上下文、挑选变换、反复调用冻结的 ICON,再决定如何融合预测。数值模型则从这些上下文中学习预测关系,给出仅靠语言难以可靠产生的定量结果。
这构成了一个协作闭环:语言智能帮助发展、配置和有策略地使用数值智能;数值智能则通过对科学与社会系统的精确预测,为语言智能提供 grounding,并拓展它可以解决的问题范围。UNICON 给出了一个具体例子:由 LLM agent 设计的 harness 在不改变权重的情况下,提升了同一个冻结数值模型的预测。更广义地说,这种分工指向一个由语言与数值模块互操作形成的智能生态,而不是期待一个单体模型包揽所有能力。
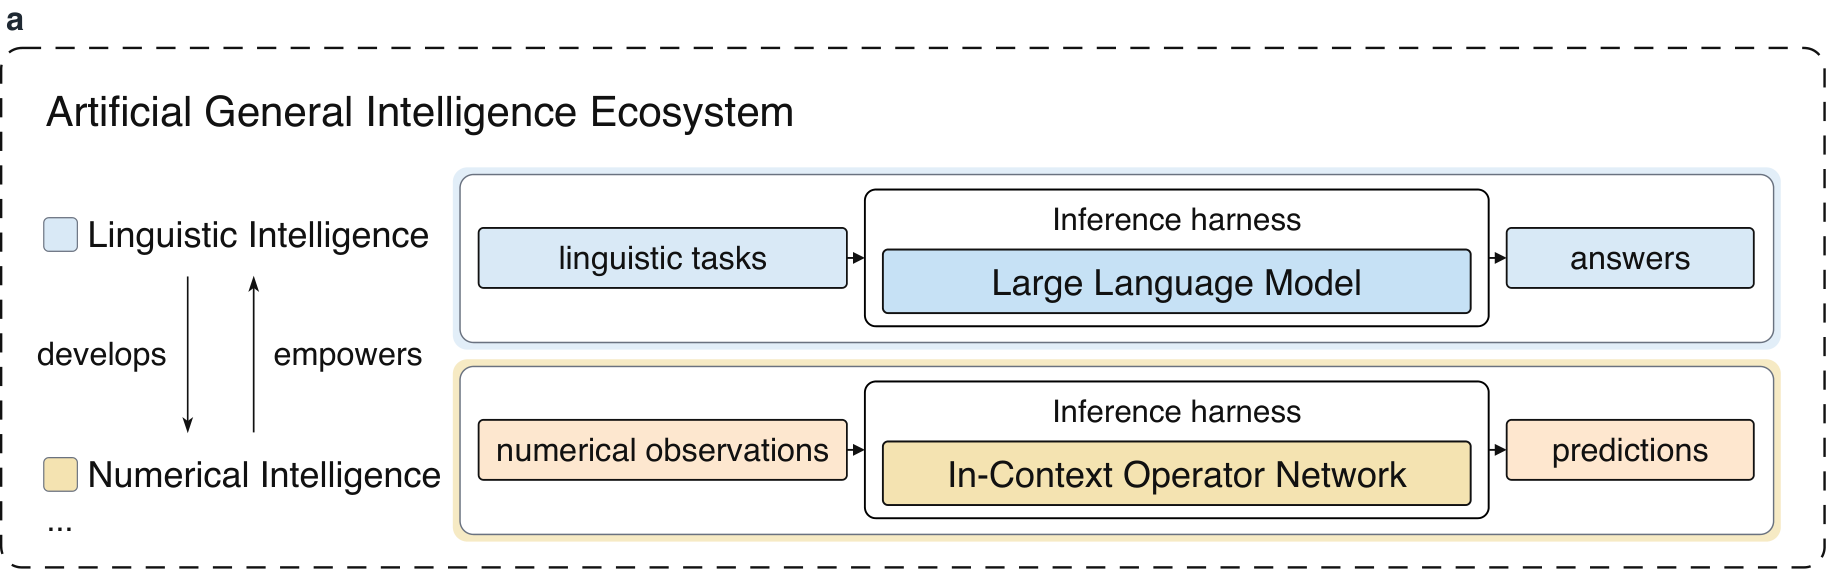
图 6:语言智能与数值智能作为人工通用智能生态中相互补充的组成部分。
数值智能研究计划
这些工作共同构成了一项数值智能研究计划:训练让模型学会如何从上下文中学习,上下文则提供当前问题所需的知识。
推进这一研究计划,需要共享模型、多样化数据集、跨学科 benchmark、推理方法和具体应用。我们构建了开源基础设施 icon-core,将模型实现、训练流程和示例组织成可供社区复用的技术栈。
为了加速数值智能研究,我们构建了 Evolving Ensemble of Agents(EvE)(GitHub,相关文章):一个将强大的 coding agents 组织成去中心化、共同演化 ensemble 的自我改进系统。EvE 不重新设计基础 agents,而是让决定 agent 行为的 guidance 和 skills 与代码仓库中的候选解共同演化。我们已经使用 EvE 迭代 ICON 的模型架构并设计 inference harness,把自动化研究直接纳入推进数值智能的过程。